ElevenLabs ahora copia una voz con 10 segundos de audio, en más de 90 idiomas
ElevenLabs lanzó Eleven v4 el lunes. Es un modelo de voz que, según la empresa, está pensado para audiolibros, personajes, locuciones y doblaje, y puede hacer una copia instantánea de una voz a partir de 10 segundos de audio y luego ponerla a hablar en más de 90 idiomas. La semana pasada Google pedía 30 segundos y un “sí” dicho en voz alta. La muestra de hoy dura la tercera parte, y el anuncio del lanzamiento no menciona el consentimiento ni una vez.
Dos modelos, una muestra muy corta
ElevenLabs presentó dos modelos el 28 de septiembre: Eleven v4, que describe como el más expresivo hasta ahora, y Eleven v4 Turbo, una versión más rápida para agentes de voz que conversan con clientes en tiempo real. Los dos ya están disponibles en la aplicación para creadores, en la plataforma de agentes y en la API para desarrolladores.
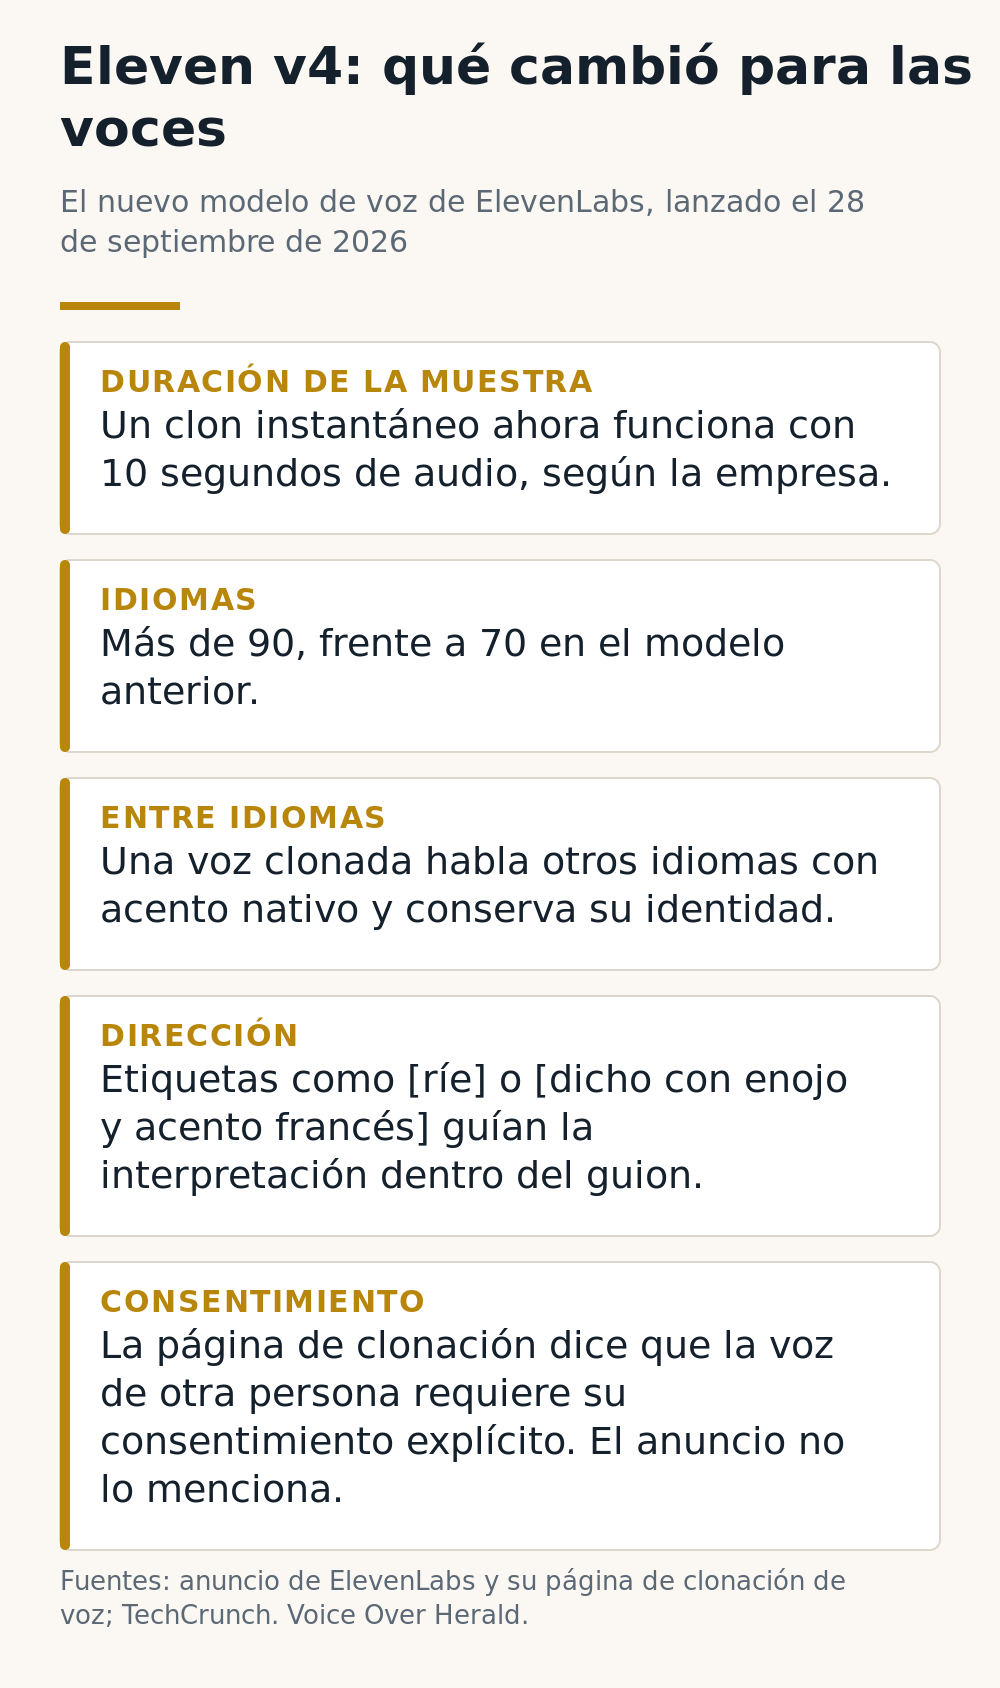
La línea que más importa a los actores de voz está cerca del final del anuncio. “Las clonaciones instantáneas de voz ahora pueden capturar voces con alta fidelidad usando solo 10 segundos de audio”, escribe la empresa. El modelo también “añade compatibilidad con las clonaciones profesionales de voz (PVC), para los usos de clonación de mayor fidelidad”.
Diez segundos es menos que la mayoría de los comerciales. Es menos que el primer spot de un demo típico. Quien tenga un demo público, un canal de YouTube o haya sido invitado a un pódcast ya publicó esa cantidad de audio muchas veces.
Ivan Mehta, de TechCrunch, informa que el número de idiomas sube de 70 en el modelo anterior a más de 90, y que ElevenLabs registró su mayor salto de calidad en japonés, portugués de Brasil, mandarín y cantonés. Son cuatro de los mercados de doblaje con más trabajo del mundo.
Lo venden como intérprete, no como lector
Si un actor de voz lee el anuncio, parece un brief de casting. Los modelos están “hechos para contenidos donde la interpretación importa tanto como las palabras, ya sean audiolibros, personajes, locuciones, doblaje o la localización de agentes conversacionales”, dice ElevenLabs.
El ejemplo que eligen es de clase de actuación. Una frase como “Necesito que te calmes” debe sonar distinta según quién la diga, explica la publicación, “ya sea un médico que se la dice con suavidad a un paciente asustado o un personaje de videojuego que se la grita a su escuadrón antes de lanzarse a la batalla”.
La dirección ahora viene dentro del guion. El usuario escribe etiquetas como [ríe], [dicho con enojo y acento francés], [lluvia suave] o [teléfono vibrando], y la empresa asegura que “Eleven v4 sigue estas etiquetas de audio e indicaciones de dirección con más precisión que los modelos anteriores, así que obtienes la interpretación que describes”. Es el trabajo de un director y un actor en cabina, escrito en un cuadro de texto.
Una voz, todos los idiomas
La función más delicada para el doblaje es la clonación entre idiomas. “Ahora, una voz grabada en un idioma también habla cualquier otro con fluidez, adopta el acento de un hablante nativo y conserva la identidad de la original”, dice ElevenLabs. En Martin Cid Magazine, Susan Hill lo explica sin rodeos: “el clon de un hispanohablante que lee en alemán sigue sonando como esa persona, con acento alemán nativo”.
 VoiceEditSuiteClean a session in ninety seconds, not three hours.
Para un estudio, eso significa que una sola sesión en inglés podría convertirse, en teoría, también en las pistas en español, portugués y japonés. Para los actores que antes grababan esas pistas, es justo el escenario del que vienen advirtiendo todo el año. Fabio Azevedo, presidente de la Asociación Brasileña de Profesionales del Doblaje y voz brasileña de Doctor Strange, le dijo a Rest of World en abril: “Hacemos que el contenido extranjero suene brasileño con nuestras particularidades brasileñas; con la IA, eso se pierde”. El portugués de Brasil es uno de los cuatro idiomas que ElevenLabs destaca como los que más mejoraron.
Diez segundos, y la pregunta del consentimiento
El anuncio del lanzamiento no dice nada sobre el consentimiento. La página de clonación de voz de la empresa sí: “Puedes clonar tu propia voz libremente para cualquier fin. Clonar la voz de otra persona requiere su consentimiento explícito”. La nota de Unite.AI sobre el lanzamiento señala que las clonaciones profesionales requieren el consentimiento verificado del dueño de la voz.
Gemini 3.8 Flash TTS
Una muestra de 30 segundos. Antes de crear el clon, el dueño de la voz graba una declaración de consentimiento y el sistema comprueba que coincida con la muestra.
Eleven v4
Una muestra de 10 segundos para un clon instantáneo. La página de clonación dice que la voz de otra persona requiere su consentimiento explícito. El anuncio no lo menciona.
Es una salvaguarda distinta a la que anunció Google la semana pasada. Como informó Voice Over Herald, los nuevos modelos de voz de Google piden al dueño que diga que sí en voz alta, en una grabación que el sistema compara con la muestra. Una voz que coincide es más difícil de falsificar que una casilla marcada.
En el blog de OrcaRouter, dirigido a desarrolladores, Gideon Frost sostiene que una muestra más corta sube lo que está en juego en lugar de bajarlo. “El problema del consentimiento no se achica con la muestra. Crece, porque la exigencia para producir un clon convincente se redujo a un fragmento que cualquiera puede grabar”, escribe. Si clonas una voz que no es tuya, agrega, “la cuestión del cumplimiento ahora te toca responderla por completo antes de llamar a la API”, porque “el modelo hará lo que le pidas”.
Hill también advierte del riesgo fuera del estudio: “a un estafador le basta una muestra corta de la voz de un familiar para montar una llamada de emergencia falsa”.
El dinero detrás del modelo
ElevenLabs no es un laboratorio pequeño que experimenta por su cuenta. TechCrunch informa que sus ingresos anualizados pasaron de unos 330 millones de dólares a principios de año a más de 600 millones, que recaudó 500 millones de Sequoia con una valuación de 11 000 millones y que “más del 55 % de su negocio” ya viene de grandes empresas. Su director ejecutivo, Mati Staniszewski, le dijo al medio que la empresa apunta a salir a bolsa “en los próximos años”.
Los oyentes cuentan otra historia. En julio, el director ejecutivo de la Audio Publishers Association, Jim Dinegar, le dijo a Publishers Weekly que “la voz humana es claramente la preferida de los oyentes de audiolibros”. El mismo informe situó los títulos narrados con IA en el 0,03 % de los ingresos por venta de audiolibros en 2025.
Qué pueden hacer ahora los actores de voz
Lee la cláusula de IA antes de firmar. Ganessh Divekar, secretario general de la Asociación de Artistas de Voz de la India, describió el nuevo hábito a Rest of World: “Ahora les decimos a los miembros que pregunten para qué se usará y que pidan más dinero cuando firmen contratos a perpetuidad”. Con un umbral de 10 segundos, una cláusula a perpetuidad sobre una sola frase merece leerse dos veces.
Sabe dónde está tu audio. Cada demo, reel y entrevista pública ya es lo bastante larga para clonarse. No es motivo para esconder tu trabajo. Es motivo para saber dónde está, y así detectar una copia cuando aparezca.
Mira a Tokio mañana. El 30 de septiembre un tribunal de Tokio debe fallar en el caso de Kenjiro Tsuda contra TikTok por una copia de su voz hecha con IA, el primer fallo de este tipo en Japón. Lo que decidan los jueces sobre una voz famosa marcará hasta dónde puede llegar un intérprete cuando un desconocido copia la suya.
La tecnología ya está hecha para elegir, dirigir y localizar en una sola pasada. Lo que no puede aportar es lo que protege el consentimiento: una persona real que aceptó que la escucharan así.
Fuentes: TechCrunch (Ivan Mehta, 28 de septiembre de 2026); ElevenLabs, “Introducing Eleven v4, our most emotive model” y la página de clonación de voz de ElevenLabs; Unite.AI; Martin Cid Magazine (Susan Hill); blog de OrcaRouter (Gideon Frost); Rest of World (Rina Chandran, 15 de abril de 2026); Publishers Weekly (Ed Nawotka, 14 de julio de 2026); Voice Over Herald. Las citas de fuentes en inglés fueron traducidas por Voice Over Herald.
Read this article in English: ElevenLabs Now Copies a Voice From 10 Seconds of Audio, in More Than 90 Languages
¿Sabe algo más sobre esta noticia, o ha visto un error? Escriba a la redacción.